Cloudflare 六月发了篇博客 Build your own vulnerability harness,讲他们怎么用 AI 在 128 个仓库里批量挖漏洞。文章末尾顺手把整个系统的起点开源了:一个叫 security-audit 的 coding-agent skill。三个月不到 4400 star。
我把它下下来读了一遍,又在自己的一个 PHP 项目上跑了一次。说说值不值得装。
它是什么
一个目录,16 个文件,没有依赖。1900 行 markdown 加两个零依赖的 node 校验脚本,总共约 45k token。
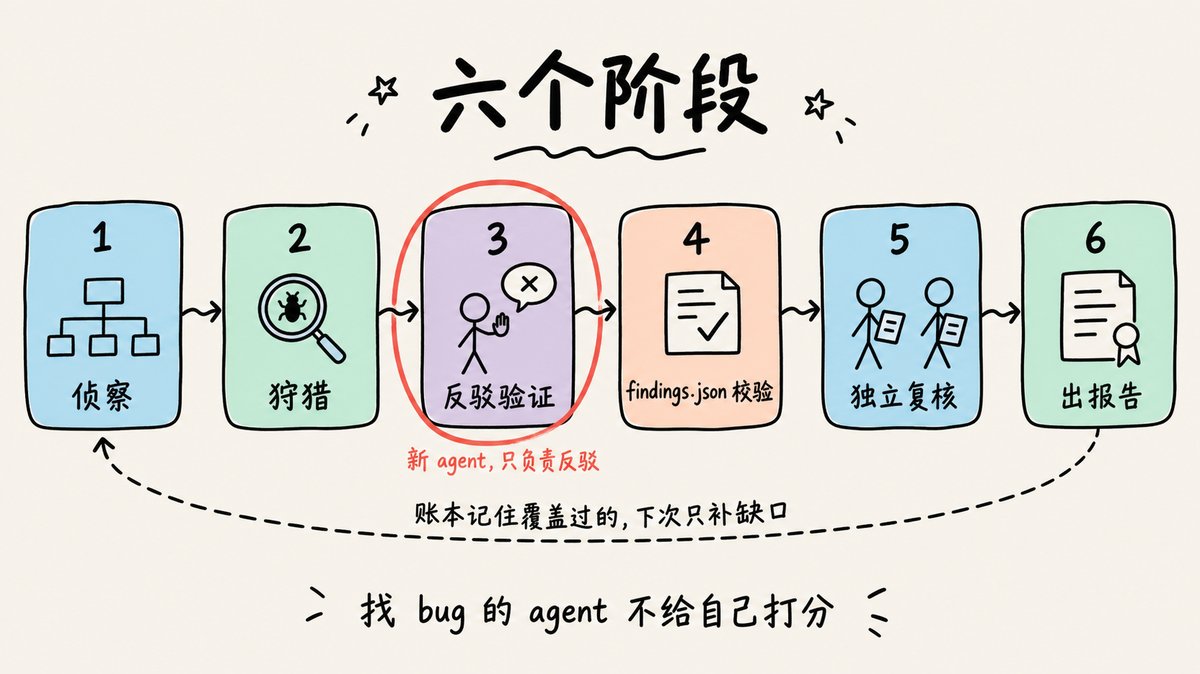
核心是六个阶段:
- Reconnaissance:几个 agent 并行读代码,画出架构、信任边界、输入面,产出 architecture.md 和一份覆盖账本 coverage-ledger.json。
- Hunting:按账本上的单元派”猎人”agent,每个只负责自己那块边界,回来交一份结构化 JSON。再派一个”critic”看账本哪里没覆盖到。
- Validation:每个候选漏洞交给一个没参与过挖掘的新 agent,任务是反驳它。
- 写 findings.json,用 schema 和 node 脚本做校验。
- 再来一批新 agent 独立复核最终的源码引用。
- 出报告:REPORT.md、FINDINGS-DETAIL.md、NEEDS-VALIDATION.md。
另外附 11 个攻击类别文件,按目标类型选:web/auth、client-side、AI/LLM、供应链、云部署、RPC/消息、资源耗尽、数据隔离、桌面/移动 IPC、内存安全。
设计上我觉得对的几点
找 bug 的人不能给自己打分。 Cloudflare 原话:”If a Hunter is allowed to grade its own homework, it will confidently validate everything.” 这条我深有体会。直接问 Claude “看看有没有安全问题”,它会给你一堆看起来很像漏洞的东西,其中多少是真的,得你自己去验。
只有三种结论。 confirmed 必须有完整的源码链路和可观察的结果;needs_validation 是”有个具体事实我在源码里看不到,比如反代有没有加这个 header”,而且不给严重等级;rejected 是被反驳掉的。这套分类把”疑似”这种最烦人的状态给堵死了。
纵深防御缺一层不算漏洞。 A 层已经挡住了攻击,B 层缺失只是 hardening note。做过安全评审的都知道,报告里 80% 的条目是这种。
确定性的事交给代码。 findings.json 有 schema,两个 node 脚本校验行号、trace 顺序、fingerprint 稳定性。测试我跑了,全过。
多跑几次是加性的。 账本会记住上次覆盖了什么,下次只补缺口。他们说单跑一次大约只能找到反复跑的一半。
代价
token 很贵。 每个 hunter 的 prompt 要求把 architecture.md、选中的攻击类别块、schema 的相关分支逐字塞进去。一个 hunter prompt 二三十 KB 起。就算 quick 模式,最少也要 4 个 recon agent、1 个 critic、每个候选 1 个 verifier。
需要 OS 级沙箱才能跑目标代码。 没有网络隔离、空环境变量、只读挂载、资源限制这一整套,skill 会拒绝执行任何目标代码,一切需要跑起来验证的东西都变成 needs_validation。对个人开发者来说,这基本等于只做静态分析。
文档写给机器,不是写给人的。 有一段 11 步的”artifact promotion procedure”,讲怎么用 no-follow 的目录描述符、fstat 检查 link count、独占创建目标文件……要求原样复制进每个 hunter 和 verifier 的 prompt。这明显是他们 harness 里的规范直接搬过来的。读的时候我一度怀疑自己在看内核文档。
平台兼容有坑。 issue 里有人报 Antigravity 会杀掉并行 subagent。整套流程重度依赖”parent 派 subagent、subagent 不能写共享文件”这个模型,换个 agent 平台就得自己对一遍。
实际跑一次
光读不算数,我在自己一个 PHP 电商项目上跑了一次。挑了支付模块,12 个文件,quick profile,预算 7 个 agent,没有沙箱,纯静态。
结果:
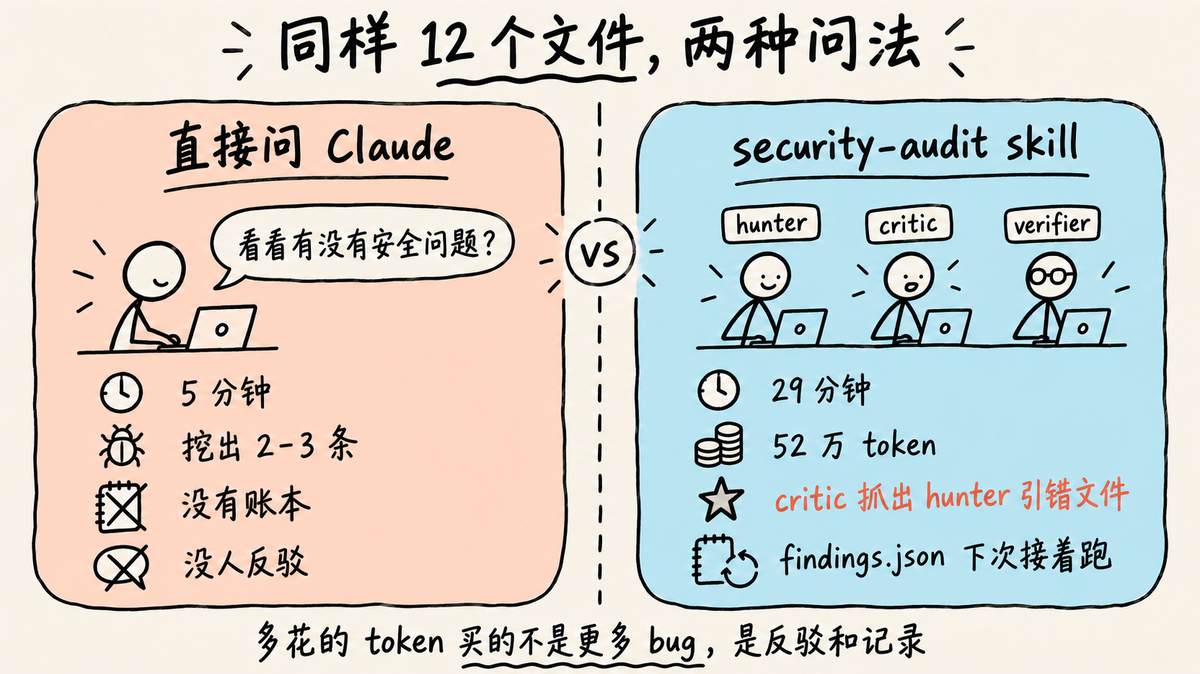
- 29 分钟,实际用了 6 个 agent:2 个 hunter、1 个 critic、3 个 verifier。recon 那 4 个 agent 预算不够,只能自己手动做。
- 总共烧了大约 52 万 token。hunter 一个 12 到 14 万,critic 13 万。
- hunter 的 prompt 42 KB 和 46 KB,critic 的 95 KB。大到没法直接塞进 Agent 调用,只能写进文件让它自己读。
- 校验脚本只挑了一次刺:账本里某个起始路径末尾多了个斜杠。剩下折腾的 8 分钟全是我自己的 zsh 引号问题。
- 产出:confirmed 0,needs_validation 3,rejected 0。三条都是支付回调和订单归属校验上的真问题,每条都卡在一个”源码里看不到、要跑起来才知道”的事实上。没沙箱,confirmed 这一栏注定是空的。
最有意思的一条反而没进报告。第一个 hunter 报了一个支付成功页的问题,critic 复核时发现它把文件读错了,但顺手指出了同一个页面上另一个更实在的授权缺口。按 quick profile 的规矩,critic 发现的新东西只能记成 deferred,不能再派人去追。规矩是对的,结果是可惜的。
对比一下:同样这 12 个文件,直接让 Claude “看看支付有没有安全问题”,5 分钟能挖出其中两三条,没有账本、没有第二个 agent 来反驳、也没有 findings.json。多花的那 50 万 token 买的不是更多 bug,是 critic 抓出 hunter 引错文件这件事,和一份下次能接着跑的记录。
装不装
看你要什么。
只是想让 AI 看一眼代码有没有明显问题?不用装。直接问,或者用 Claude Code 自带的 /security-review 看当前改动。这个 skill 的 guidance mode 干的也是这个事,加载 5.5k token 的 SKILL.md 换来的主要是”什么不算漏洞”那几条纪律。
有个对外的服务,想隔一阵做一次正经审计,要一份能跨次比对的报告?值得装。用 quick profile,设个预算,挑一个子系统跑。findings.json 的 fingerprint 设计让下次跑能接着上次的账本走,这是随口问 AI 做不到的。
还有第三种用法:不装,只读。ATTACK-CLASSES.md 里的”Business logic”和”Feature abuse”两节,AI-AND-LLM.md 里关于 MCP 和 tool-calling 的那几段,本身就是很好的 checklist。做 agent 或 MCP server 的人尤其该看一遍。
装的话一行:
npx skills add https://github.com/cloudflare/security-audit-skill --skill security-audit --global这个 skill 最值钱的不是那 11 个攻击类别,是它对”什么才算一个漏洞”的定义。Cloudflare 自己已经把它进化成一个 3 到 14 小时跑一次、50 到 200 个 worker 的 harness 了。开源出来的这份是种子。种子能不能长,看你有没有那块地。
0